هر عدد، پیش از آنکه به نمودار برسد، از چند تصمیم عبور کرده است: چه چیزی را بشماریم، چه کسی را در کدام دسته قرار دهیم و غیبت چه کسی را نادیده بگیریم. «فمینیسم داده» کتابی درباره همین تصمیمهاست؛ درباره قدرتی که پشت ظاهر خونسرد آمار پنهان میماند.
وقتی نهادی میگوید درباره خشونت علیه زنان، کار مراقبتی، فقر یا تبعیض «داده کافی در دست نیست»، ممکن است این جمله مانند اعترافی فنی به نظر برسد؛ گویی چند فرم پر نشده یا چند جدول ناقص مانده است. اما نبودن داده همیشه یک اتفاق بیطرفانه نیست. گاهی نشان میدهد زندگی چه کسانی برای ثبتکردن مهم دانسته نشده، چه رنجی نام نگرفته و کدام مسئله هرگز به مرحله بودجهگذاری و سیاستگذاری نرسیده است.
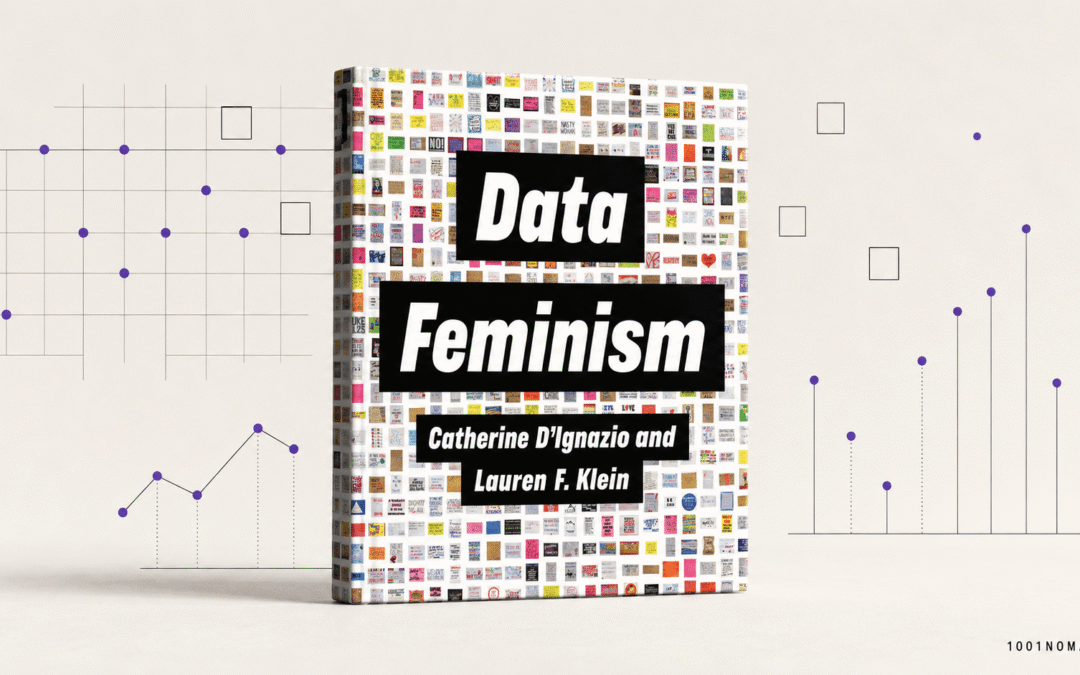
«فمینیسم داده» نوشته کاترین دیگنازیو و لورن اف. کلاین از همین نقطه آغاز میکند. کتاب در سال ۲۰۲۰ از سوی انتشارات MIT منتشر شد؛ زمانی که تصمیمهای دادهمحور مدتها بود از بیمارستان و دانشگاه تا بازار کار، پلیس و شبکههای اجتماعی گسترش یافته بود، اما هنوز بسیاری از روایتهای مسلط درباره فناوری، آن را قلمرویی خنثی، فنی و جدا از مناسبات اجتماعی معرفی میکردند.
دیگنازیو پژوهشگر، طراح و مدیر «آزمایشگاه داده و فمینیسم» در MIT است و کلاین در دانشگاه اموری در مرز میان علوم داده، علوم انسانی و تاریخ بازنمایی اطلاعات کار میکند. این پیشینه دوگانه در سراسر کتاب دیده میشود: «فمینیسم داده» نه رسالهای صرفاً نظری درباره فمینیسم است و نه راهنمایی فنی برای برنامهنویسان. کتاب میخواهد میان این دو جهان پلی بسازد و یک پرسش ساده اما مزاحم را مرتب پیش بکشد: داده به دست چه کسی، درباره چه کسی و در خدمت منافع چه کسی تولید میشود؟
وقتی «داده نداریم» خودش یک داده است
یکی از مهمترین ایدههای کتاب این است که خلأهای آماری را باید جدی گرفت. دادههای مفقود فقط خانههای سفید یک جدول نیستند؛ گاهی نتیجه مستقیم بیتوجهی سازمانیافتهاند. اگر نهادی سالها قتل زنان را در طبقهای مستقل ثبت نکند، نبود آمار را نمیتوان نشانه نبود مسئله دانست. اگر کار بیمزد خانگی اندازهگیری نشود، نمیتوان نتیجه گرفت که ارزش اقتصادی ندارد. آنچه شمرده نمیشود، بهآسانی از اولویتهای عمومی نیز کنار میرود.
نویسندگان برای توضیح این موضوع به کنشگرانی اشاره میکنند که در غیاب آمار معتبر دولتی، خود به گردآوری «دادههای مقابلهای» روی آوردهاند. یکی از نمونههای کتاب، نقشهای است که ماریا سالگرو برای ثبت زنکشیها در مکزیک ساخت. او گزارشهای مطبوعاتی و اطلاعات شهروندان را کنار هم گذاشت تا مکان و الگوی قتلهایی را آشکار کند که در نظام رسمی، پراکنده یا ناپیدا مانده بودند. این کار فقط جمعزدن چند عدد نبود؛ بازگرداندن نام و مکان به زنانی بود که خطر داشتند در سکوت آماری ناپدید شوند. فصل نخست کتاب این نوع گردآوری داده را شکلی از مواجهه با قدرت میداند.
برای خواننده ایرانی، این بحث ناآشنا نیست. میان تجربه زیسته زنان و تصویری که جدولهای رسمی ارائه میکنند، بارها فاصلهای بزرگ وجود دارد. خشونت خانگی ممکن است زیر عنوان مبهم «اختلاف خانوادگی» محو شود؛ کار مراقبتی در محاسبات اقتصادی دیده نشود؛ و تجربه زنانی که همزمان با تبعیض جنسیتی، فقر، معلولیت، مهاجرت، تعلق قومی یا سرکوب سیاسی روبهرو هستند، در دستهبندیهای کلی از میان برود. کتاب یادآوری میکند که پیش از پرسیدن «عدد چند است؟» باید پرسید چه کسی اصلاً فرصت پیدا کرده در این عدد حضور داشته باشد؟
فمینیسم فقط افزودن یک ستون به جدول نیست
«فمینیسم داده» را نباید پروژهای برای افزودن برچسب «زن» به همان نظامهای قدیمی دانست. نویسندگان از فمینیسم تقاطعی الهام میگیرند؛ رویکردی که نشان میدهد جنسیت جدا از طبقه، نژاد، قومیت، گرایش جنسی، معلولیت، سن و جغرافیا عمل نمیکند. یک میانگین کلی ممکن است ظاهری منظم داشته باشد و در همان حال، تفاوت میان گروههای مختلف زنان را بپوشاند.
همین نگاه، کتاب را از نسخههای کمخطر «تنوع» جدا میکند. مسئله فقط این نیست که چه تعداد زن در یک شرکت فناوری استخدام شدهاند. باید پرسید چه کسانی اختیار تعریف مسئله را دارند، چه کسانی بودجه را کنترل میکنند، کدام تجربهها بهعنوان دانش معتبر پذیرفته میشوند و پیامد خطای یک سامانه بر زندگی چه گروهی سنگینی میکند. حضور چند زن در اتاق تصمیمگیری، اگر قواعد اتاق دستنخورده باقی بماند، الزاماً به عدالت نمیانجامد.
هفت اصل برای دیدن قدرت پشت عددها
ساختار کتاب بر هفت اصل بنا شده است. دو اصل نخست، بررسی قدرت و بهچالشکشیدن قدرت هستند. فمینیسم داده از تشخیص نابرابری متوقف نمیشود؛ از پژوهشگر و کنشگر میخواهد ببیند چگونه میتوان دانشی تولید کرد که به تغییر مناسبات نابرابر کمک کند.
اصل سوم، ارجنهادن به احساسات و بدنمندی است. علم مدرن اغلب فاصلهگرفتن از عاطفه و تجربه شخصی را شرط بیطرفی دانسته است، اما نویسندگان میپرسند چرا دانشی که از بدن، ترس، درد یا مراقبت به دست میآید باید کماعتبارتر تلقی شود. تجربه زیسته جای روش دقیق را نمیگیرد؛ بخشی از واقعیتی است که روشهای ظاهراً خنثی ممکن است نبینند.
اصل چهارم ما را به بازنگری در دوگانهها و سلسلهمراتبها دعوت میکند. دستهبندیها برای تحلیل ضروریاند، اما طبیعی و ابدی نیستند. وقتی یک فرم فقط دو گزینه زن و مرد دارد، افرادی را که در این دوگانه نمیگنجند از همان نقطه ورود حذف میکند. این حذف بعداً میتواند در سیاستگذاری، خدمات عمومی و تخصیص منابع تکرار شود.
سه اصل بعدی عبارتاند از پذیرش کثرت دیدگاهها، درنظرگرفتن زمینه و آشکارکردن کار پنهان. دانشی که از مشارکت جامعه محلی، تجربه مستقیم و دیدگاههای متفاوت ساخته شود، کاملتر از دانشی است که از بالا و بدون شناخت زمینه تولید میشود. عدد نیز بدون تاریخ گردآوری، تعریف متغیرها و مناسبات اجتماعی پیرامونش معنای روشنی ندارد. ساختار کامل کتاب نشان میدهد که این اصول جدا از هم نیستند؛ هر کدام راهی برای دیدن بخشی از قدرتیاند که در فرایند جمعآوری، طبقهبندی و تفسیر داده عمل میکند.
ماشینها هم بیطرف به دنیا نمیآیند
یکی از نمونههای ماندگار کتاب به پژوهش جوی بولاموینی مربوط است؛ پژوهشگری سیاهپوست که متوجه شد یک سامانه تشخیص چهره، صورت او را بهدرستی نمیبیند، اما با قرارگرفتن یک ماسک سفید روی صورتش واکنش نشان میدهد. مشکل فقط چند خط کد نبود. مجموعه داده آموزشی، انتخاب طراحان و ترکیب کسانی که سامانه را آزموده بودند، همگی در تولید این خطا سهم داشتند.
این مثال در دوران گسترش هوش مصنوعی معنایی فوریتر پیدا کرده است. سامانههای هوشمند جهان را از دادههای گذشته میآموزند؛ دادههایی که تاریخ تبعیض نیز در آنها ثبت شده است. اگر زنان در برخی مشاغل کمتر حضور داشتهاند، یک الگوریتم استخدام ممکن است همان نابرابری را بهعنوان الگوی موفقیت بازتولید کند. اگر زبان، چهره یا تجربه گروهی در داده آموزشی کم باشد، سامانه آن گروه را بدتر میشناسد. فناوری در چنین وضعی تبعیض را اختراع نمیکند؛ آن را با سرعت و مقیاسی تازه ادامه میدهد و گاهی پشت اعتبار ظاهری محاسبه پنهان میکند.
برای کاربران فارسیزبان، پرسش حتی بنیادیتر است: دادههای فارسی را چه کسانی تولید کردهاند؟ کدام گروههای اجتماعی در آن بیشتر نمایاناند؟ روایت چه کسانی بهدلیل سانسور، دسترسی نابرابر به اینترنت یا حذف از رسانههای رسمی کمتر وارد آرشیو دیجیتال شده است؟ کتاب پاسخ آمادهای برای ایران ندارد، اما ابزار پرسیدن این سؤالها را در اختیار ما میگذارد.
پشت هر «سامانه خودکار»، دستهایی نامرئی کار میکنند
اصل پایانی کتاب، آشکارکردن کار، یکی از فمینیستیترین بخشهای آن است. صنعت فناوری محصولات خود را با واژههایی مانند خودکار، هوشمند و بدون دخالت انسان معرفی میکند، حال آنکه پشت بسیاری از این سامانهها، انسانهایی مشغول برچسبزدن تصاویر، پالایش محتوا، پاکسازی داده و اصلاح خطاها هستند. این کارها اغلب کمدستمزد، قراردادی و ناپیدا باقی میمانند.
کتاب میان این نیروی کار پنهان و تاریخی طولانیتر پیوند برقرار میکند: همان منطقی که کار خانگی، مراقبت از کودک، پرستاری از سالمند و کار عاطفی زنان را «طبیعی» و بنابراین کمارزش جلوه داده، در اقتصاد داده نیز بخشی از نیروی انسانی را پشت تصویر جادویی ماشین پنهان میکند. فصل «کار خود را آشکار کنید» از ما میخواهد در برابر هر محصول دادهمحور بپرسیم چه کسانی آن را ساختهاند، نام چه کسانی ثبت شده و کار چه کسانی از قاب بیرون مانده است.
کتاب کجا کم میآورد؟
«فمینیسم داده» کتاب مهمی است، اما جهانشمول نیست. بخش بزرگی از مثالها، نهادها و منازعات آن از ایالات متحده میآیند. نویسندگان جایگاه خود را بهعنوان دو زن سفید دانشگاهی پنهان نمیکنند و حتی سازوکاری برای بررسی منابع و سنجش میزان حضور گروههای مختلف در کتاب طراحی کردهاند. این خودآگاهی ارزشمند است، اما فاصله کتاب با تجربه جوامعی مانند ایران را از میان نمیبرد.
خواننده ایرانی باید چارچوب کتاب را بگیرد و مثالهایش را دوباره در زمینه خود بیازماید؛ در ساختاری که دادههای عمومی محدود، سانسور گسترده و دسترسی به اطلاعات نابرابر است و گاهی ثبتکردن یک نام یا واقعه میتواند برای منبع خبر خطر امنیتی ایجاد کند. اخلاق داده در چنین محیطی فقط مسئله دقت نیست؛ مسئله امنیت، رضایت و حق فراموششدن نیز هست.
از سوی دیگر، نثر کتاب با وجود مثالهای روشن، گاهی دانشگاهی و تکرارشونده میشود. الیزابت گاربی در نقدی در نشریه Issues in Science and Technology نیز میپرسد مخاطب اصلی این اثر دقیقاً کیست و آیا خواننده عادی بهآسانی با حجم بحثها و ارجاعات آن همراه میشود. این تردید بجاست. «فمینیسم داده» کتابی نیست که در یک نشست خوانده شود؛ بهتر است فصلبهفصل و همراه با مثالهای بومی مطالعه شود.
کتاب همچنین در سال ۲۰۲۰، پیش از انفجار عمومی هوش مصنوعی مولد، منتشر شده است. بنابراین نباید از آن انتظار داشت همه مناقشات امروز درباره مدلهای زبانی، جعل عمیق یا استخراج گسترده داده را پوشش دهد. بااینحال، درست به همین دلیل اصولش همچنان کار میکنند: فناوری عوض شده، اما پرسشهای قدرت، حذف، طبقهبندی و کار پنهان باقی ماندهاند.
ترجمهای فارسی، بیرون از بازار رسمی نشر
ترجمه کامل فارسی «فمینیسم داده» را امیرحسین پیبراه انجام داده و در مارس ۲۰۲۴ بهصورت رایگان روی وبسایت کتاب در MIT Press قرار داده است. مترجم در یادداشت خود نوشته که دسترسی همگانی به دانش یکی از دلایل انتشار رایگان این ترجمه بوده است. متن فارسی را میتوان فصلبهفصل خواند یا در قالبهایی مانند PDF و EPUB دریافت کرد.
تا زمان نگارش این معرفی، ۱۰۰۱NOMADS نتوانست نسخهای با شناسنامه نشر و چاپ تأییدشده در ایران برای این عنوان پیدا کند. بنابراین دقیقتر است که آن را ترجمه فارسیِ آزاد و آنلاین معرفی کنیم، نه کتابی که از سوی ناشری در ایران منتشر شده باشد. این تفاوت برای معرفی درست اثر مهم است؛ اما از ارزش دسترسی رایگان و کامل به متن کم نمیکند.
این کتاب برای چه کسانی است؟
«فمینیسم داده» فقط برای برنامهنویسان یا پژوهشگران آمار نوشته نشده است. روزنامهنگاران، کنشگران حقوق زنان، پژوهشگران اجتماعی، طراحان، دانشجویان و هر کسی که برای اثبات یک مسئله به عدد و نمودار متکی است، میتواند از آن استفاده کند. این کتاب به روزنامهنگار یادآوری میکند که در برابر هر آمار بپرسد چه کسی آن را تولید کرده، تعریفها چه بوده، چه مواردی ثبت نشده و انتشار داده چه خطری برای افراد ایجاد میکند. به کنشگر نیز نشان میدهد که گردآوری داده میتواند ابزاری برای مرئیکردن بیعدالتی باشد، به شرط آنکه جامعه موضوع تحقیق فقط «منبع اطلاعات» نباشد و در تعریف مسئله و استفاده از نتیجه سهم داشته باشد.
ارزش اصلی کتاب در دعوت به بیاعتمادی مطلق به عددها نیست. دیگنازیو و کلاین نمیگویند داده را کنار بگذاریم؛ میگویند آن را از تاریخ، بدن و سیاست جدا نکنیم. عدد میتواند خشونت را آشکار کند، اما میتواند آن را پشت یک میانگین پنهان کند. میتواند کار نامرئی را ثبت کند یا همان نامرئیبودن را رسمی سازد. تفاوت را نه خود داده، بلکه پرسشهایی تعیین میکنند که پیش از جمعآوری آن میپرسیم و مسئولیتی که پس از انتشارش میپذیریم.
«فمینیسم داده» در نهایت از ما میخواهد هنگام مواجهه با هر جدول، نمودار یا الگوریتم، یک پرسش را فراموش نکنیم: چه کسی در این تصویر حضور ندارد و غیبت او به سود چه کسی تمام میشود؟
مشخصات کتاب: «فمینیسم داده»، نوشته کاترین دیگنازیو و لورن اف. کلاین، انتشارات MIT Press، ۲۰۲۰؛ ترجمه فارسی امیرحسین پیبراه، منتشرشده بهصورت آزاد و آنلاین در ۲۰۲۴.